Lien numérique · Actualité
PISA 2025 et l'IA : savoir combien ni pour quoi ne suffit pas
19 septembre 2026 · 9 min de lecture
Les microdonnées publiques de PISA 2025 (29 966 relevés espagnols du PUF) montrent que la fréquence d'usage des chatbots d'IA dans quatre tâches scolaires différentes ne se résume pas à un schéma simple avec le score. Cet article examine cette découverte sans forcer la conclusion vers « ce qui compte, c'est le jugement », et clarifie ce que dit réellement l'OCDE sur le référentiel de « l'année scolaire ».
Dans l’article précédent de cette série nous avons vu que la distraction perçue due aux ressources numériques en classe suit un schéma clair : plus la distraction perçue est élevée, plus le score est bas, sans exception. Avec les chatbots d’IA, nous nous attendions à trouver quelque chose de similaire — un tableau simple d’« bons usages » et de « mauvais usages ». Ce n’est pas ce que montrent les données, et c’est précisément la leçon de cet article.
Le titre facile que nous avons décidé de ne pas répéter
Un chiffre circule qui prétend trancher le débat : bien utiliser l’IA en classe équivaudrait à gagner une année scolaire entière par rapport à mal l’utiliser. Nous l’avons vu cité des dizaines de fois sans que personne ne dise d’où il sort exactement. Au lieu de le répéter, nous sommes allés voir le rapport officiel et les microdonnées publiques.
Notre média sœur labs.tever.es a téléchargé les microdonnées réelles de PISA 2025 : 29 966 relevés espagnols du PUF (fichier public d’usager) analysés, sur un total officiel de 29 967 élèves dans 956 établissements, le fichier public que n’importe qui peut demander directement à l’OCDE. Le résultat complet, avec le code ouvert pour que quiconque puisse le reproduire, se trouve dans leur analyse publiée. Nous racontons ici ce qu’ils ont trouvé et pourquoi cela change la question que nous devrions nous poser.
Un schéma clair, et un autre qui ne l’est pas
Quand on mesure la distraction due aux appareils numériques en classe de Sciences, le schéma est net : plus les élèves perçoivent de distraction, plus leur score moyen est bas — une différence d’environ 32 points entre ceux qui perçoivent une distraction constante et ceux qui ne la perçoivent jamais, un schéma qui reste tout aussi clair après avoir tenu compte du niveau socio-économique de la famille.
Avec l’IA, non. Le questionnaire de PISA 2025 demande à quelle fréquence les élèves utilisent des chatbots comme ChatGPT pour quatre tâches scolaires différentes : résumer un texte, chercher des informations, rédiger un devoir, ou « m’aider à apprendre » de manière générale. Si la finalité déclarée et la fréquence suffisaient à distinguer des usages plus ou moins favorables à l’apprentissage, on s’attendrait à des schémas nettement plus systématiques entre les catégories. Ce n’est pas ce qui apparaît dans les données : aucune des quatre tâches ne suit une relation simple avec le score. Pour « résumer un texte », ceux qui n’utilisent jamais le chatbot ont la moyenne la plus élevée et ceux qui l’utilisent quotidiennement la plus basse — mais entre ces deux extrêmes, il y a une forte baisse à l’usage très occasionnel, un rebond à l’usage mensuel, et une nouvelle baisse à l’usage hebdomadaire avant le minimum quotidien. Pour « chercher des informations », la moyenne la plus élevée n’appartient pas à ceux qui ne l’utilisent jamais, mais à ceux qui l’utilisent une ou deux fois par semaine. Chaque tâche dessine sa propre forme, et aucune n’est une ligne droite.
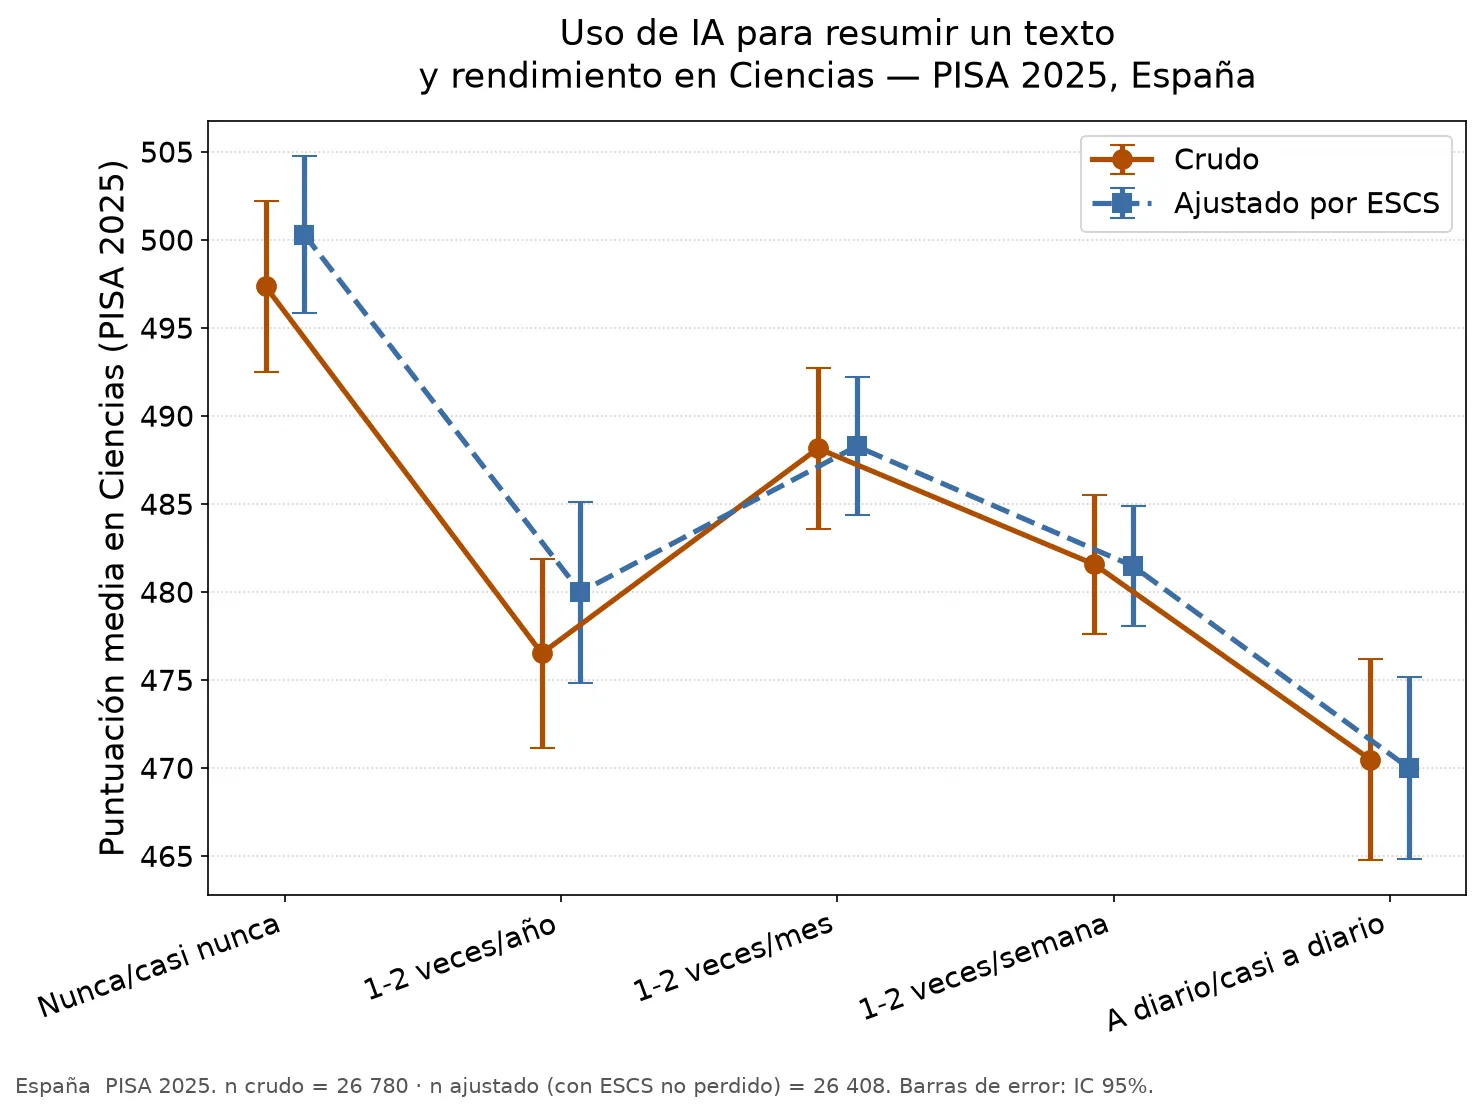
Analyse indépendante des microdonnées publiques de PISA 2025 (pas du rapport officiel) : la tâche « résumer un texte » est celle qui montre le mieux qu’il n’y a pas de schéma simple. Ce n’est pas une ligne qui descend (ni qui monte) de façon constante — elle présente une forte baisse à l’usage très occasionnel, un rebond à l’usage mensuel, une nouvelle baisse à l’usage hebdomadaire, et son minimum à l’usage quotidien. Les différences entre catégories sont descriptives ; ce graphique ne teste pas statistiquement chaque paire de fréquences. Attention aussi au possible biais de causalité inverse (expliqué plus haut) : il décrit une association à un instant donné, il ne démontre pas ce qui cause quoi. Source : analyse indépendante de labs.tever.es sur le fichier public de microdonnées de l’OCDE.
Pourquoi ce n’est pas « c’est compliqué et on ne sait pas »
On pourrait croire que la conclusion est simplement que le sujet est confus. Ce n’est pas le cas. C’est plus précis que cela : les quatre items de fréquence ne mesurent pas le jugement avec lequel l’IA est utilisée — ni la profondeur, ni la supervision, ni la vérification. Ils mesurent seulement fréquence × finalité déclarée. Le fait que les courbes diffèrent entre elles ne permet pas de déduire que « le jugement » soit la variable qui explique la différence : c’est notre propre interprétation éditoriale, pas quelque chose que les quatre items démontrent par eux-mêmes.
Un couteau n’est ni mauvais ni bon en soi. Cela dépend de qui le tient et pour quoi. Personne ne s’attend à ce qu’existe une liste fermée de « bons usages du couteau » et de « mauvais usages du couteau » qui règle la question une fois pour toutes — cela dépend du jugement de celui qui l’utilise, du contexte, de l’intention. Les données sont compatibles avec cette idée appliquée à l’intelligence artificielle en classe, mais ne la confirment pas : PISA ne démontre pas la neutralité technologique ni n’identifie le jugement comme la cause. Ce qu’il montre, c’est que la fréquence et la finalité déclarée ne suffisent pas à résumer la relation entre usage de l’IA et performance dans un schéma simple.
Le chercheur de labs.tever.es lui-même le résume avec une honnêteté que nous partageons : « avec ce type de donnée, prise à un instant donné, je ne peux pas savoir ce qui est la cause et ce qui est la conséquence ». Il se peut que celui qui utilise le plus le chatbot pour résumer des textes soit déjà en difficulté en classe et cherche de l’aide, et non l’inverse. Le questionnaire ne peut pas le distinguer, et nous non plus ne prétendrons pas le pouvoir.
Il y a, cependant, un indice supplémentaire dans le rapport lui-même qui pointe bien vers le « comment ». L’OCDE étudie si les élèves ont, à l’école, des occasions d’évaluer de manière critique la qualité de l’information générée par l’IA. Parmi les élèves qui déclarent avoir ces occasions à l’école, ceux qui utilisent l’IA pour apprendre une fois par semaine ou plus tendent à obtenir des scores légèrement supérieurs aux non-utilisateurs et aux utilisateurs moins fréquents — l’OCDE elle-même avertit que cette association ne permet pas d’établir de causalité, mais la considère compatible avec le potentiel d’un enseignement spécifique pour renforcer l’usage critique de l’IA. Les quatre items de fréquence ne mesurent pas le jugement avec lequel l’IA est utilisée, mais PISA lui-même apporte cet autre indice : lorsqu’il analyse les occasions scolaires d’évaluer de manière critique l’information générée par l’IA, une association différente apparaît. Cela ne démontre pas non plus la causalité, mais cela suggère bien que compter les usages ne suffit pas : le contexte dans lequel on apprend à l’utiliser compte.
Le chiffre viral, clarifié
Sur « l’année scolaire complète » : la source existe et c’est bien l’OCDE. Dans le résumé officiel de PISA 2025, il est dit que, pour certaines tâches spécifiques (résumer, rédiger, chercher), les non-utilisateurs d’IA devancent en moyenne les utilisateurs d’environ 20 points, et cette différence est présentée comme équivalant approximativement à une année de scolarité. Ce parallèle, cependant, demande de la prudence : l’encadré I.2.2 du rapport explique lui-même que les 20 points sont un référentiel approximatif, construit à partir de plusieurs cycles, qui varie considérablement selon les pays — d’environ 10 à plus de 25 points dans les estimations présentées — et avertit explicitement qu’aucune différence ne doit être convertie mécaniquement en « années de scolarité ». De plus, il s’agit ici d’une association observationnelle entre groupes, pas d’une année d’apprentissage causée par l’usage ou le non-usage de l’IA : le chiffre viral qui circule (« utilisez bien ou mal l’IA et gagnez ou perdez une année scolaire ») transforme une association descriptive en un effet causal que l’OCDE n’établit pas. C’est exactement le type de nuance que nous préférons clarifier avant de répéter un titre.
Pourquoi cela rejoint ce que nous défendons déjà
PISA ne démontre pas que « le jugement » cause une meilleure performance. Ce que ces données montrent bien, c’est que la fréquence et la finalité déclarée ne suffisent pas à résumer la relation entre usage de l’IA et performance ; et le rapport lui-même apporte des indices selon lesquels le contexte de littératie critique compte — cette donnée sur les occasions d’évaluer de manière critique l’information générée par l’IA, expliquée plus haut.
De là, et désormais en tant que position éditoriale de cette maison — non comme quelque chose que les données démontrent par elles-mêmes —, nous défendons la même idée que celle exprimée sur les écrans dans l’article précédent : la technologie n’est ni bonne ni mauvaise en soi, ce qui compte c’est comment, pour quoi et dans quel contexte elle est utilisée. C’est la même raison pour laquelle, dans nos propres projets (EMTI Fervienza, labs.tever.es), nous ne traitons pas l’IA comme un raccourci qui remplace le jugement de celui qui enseigne ou apprend, mais comme un outil de plus qui exige la même vigilance que n’importe quel autre.
Sources
- OCDE. PISA 2025 Results (Volume I): Future-Ready Students — chapitre « Student school life and beyond ». Items d’usage de l’IA (fréquence × finalité), Figure I.4.13, encadré I.4.2 (occasions d’évaluer de manière critique l’information générée par l’IA) et Figure I.4.14. https://www.oecd.org/en/publications/pisa-2025-results-volume-i_73451bc5-en/full-report/student-school-life-and-beyond_861e5904.html
- OCDE. PISA 2025 Results (Volume I), page générale. Source de la comparaison officielle d’environ 20 points ≈ une année de scolarité pour des tâches spécifiques d’usage de l’IA. https://www.oecd.org/en/publications/pisa-2025-results-volume-i_73451bc5-en.html
- OCDE. PISA 2025 Results (Volume I) — chapitre « Student performance in PISA 2025 », encadré I.2.2 : méthodologie et précautions du référentiel d’environ 20 points (varie selon les pays, ne doit pas être converti mécaniquement en « années de scolarité »). https://www.oecd.org/en/publications/pisa-2025-results-volume-i_73451bc5-en/full-report/student-performance-in-pisa-2025_23e075c2.html
- Tever, labs.tever.es. « PISA 2025 : IA et distraction numérique, avec des données » (analyse indépendante des microdonnées publiques, 29 966 relevés espagnols du PUF, quatre tâches d’usage de chatbots d’IA). https://labs.tever.es/blog/pisa-2025-ia-y-distraccion-en-espana